Waarom we NFS gebruiken voor geclusterde hosting
Bij Cyberfusion gebruiken we NFS (Network File System) voor geclusterde hostingomgevingen. Daarmee benaderen meerdere webservers dezelfde bestanden. Dat is bijvoorbeeld interessant voor grotere SaaS-platformen die hun applicatie over meerdere servers verdelen. De webservers delen dezelfde applicatiebestanden en gebruikersuploads, terwijl we via een loadbalancer het verkeer over meerdere nodes verdelen. Voorheen gebruikten we hiervoor CephFS.
De opslag staat op afzonderlijke servers. We gebruiken hiervoor de NFS-server in de Linux-kernel, op Debian met ZFS, binnen QEMU. In NFS-land wordt zo'n server vaak een filer genoemd, een term die nog stamt uit de tijd waarin dit doorgaans fysieke storage-appliances waren.
Centrale opslag betekent dat een open(), read() of close() communicatie met een filer vereist wanneer Linux de operatie niet vanuit de lokale cache kan afhandelen. Een RPC over het netwerk kost meer tijd dan een volledig lokale operatie, al blijft de extra latency voor veel webhostingworkloads beperkt. Hoeveel RPC's (Remote Procedure Calls) nodig zijn, hangt onder andere af van het protocol, de caching en het accesspattern van de applicatie: welke I/O-operaties worden uitgevoerd, hoe vaak en in welke volgorde?
We gebruikten NFSv4.2, de modernste versie van het NFS-protocol. Totdat we regelmatig PHP-processen zagen vastlopen tijdens gewone fileoperations.
In 'userland' merkten klanten dat bijvoorbeeld aan een WordPress-backend die incidenteel extreem traag was. Eén klant meldde dat wp-admin soms meer dan 40 seconden nodig had om te laden. Bij een test even later duurde dezelfde pagina slechts 1 seconde. De server was ondertussen niet overbelast.
PHP-processen bleven hangen in D-state
Linux kent verschillende processtatussen. Eén daarvan is D, oftewel uninterruptible sleep.
Een proces in D-state wacht op een operatie in de kernel, vaak op I/O. Denk aan een proces dat een bestand probeert te openen, maar moet wachten totdat het storagesysteem de operatie heeft afgehandeld.
Zo'n proces gebruikt ondertussen nauwelijks CPU, maar blijft wel bezet.
Op een aantal webservers zagen we regelmatig drie tot vier processen in D-state. Meestal duurde dat maar kort. Eén node viel echter op.
De betreffende hostingomgeving bestond uit vier webservers met elk acht CPU-cores en bijna 200 PHP-FPM-pools per node. Alle nodes gebruikten dezelfde NFS-mounts. Met HAProxy koppelen we websites aan specifieke nodes, waardoor de verkeersverdeling per server verschilt.
Op de opvallende node zagen we:
- Een load average over één minuut van ongeveer 8, tegenover ongeveer 3 op de andere nodes.
- Ongeveer 8 Apache-requests per seconde, tegenover 12 op een andere node.
- In een momentopname 195 bezette Apache-workers, met pieken boven de 400. Op de andere nodes waren dat er 1 tot 7.
- Een drukke PHP-FPM-pool met ongeveer 6.200 requests per uur, die permanent tegen zijn limiet van vijf gelijktijdige workers (
pm.max_children) aanzat.
De node kreeg dus minder requests binnen, maar hield aanzienlijk meer workers bezet. De gemiddelde verwerkingstijd per request was kennelijk veel hoger. Logisch: wanneer een PHP-FPM-worker op een NFS-operatie wacht, blijft die worker bezet, zonder PHP-code uit te voeren.
De Debian-upgrade: plotseling veel meer NFS-RPC's
Eén van de eerste concrete aanwijzingen kwam na een upgrade van Debian 12 (Bookworm) naar Debian 13 (Trixie).
We hadden drie webservers een dist-upgrade gegeven. Alle drie gebruikten dezelfde NFS-export en draaiden dezelfde applicaties als voorheen. Toch zagen we direct na de upgrade een forse stijging in het aantal NFS-RPC's per client.
Voorheen registreerden we ongeveer 4.000 tot 9.000 RPC's per 30 seconden. Na de upgrade waren dat er 17.000 tot 28.000. Voor zover we konden vaststellen, was de workload niet veranderd.
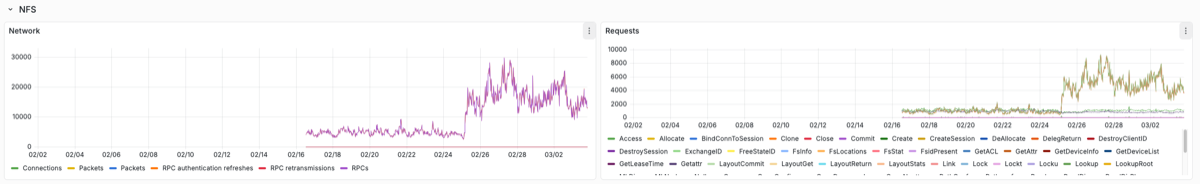
Bij nader onderzoek bleken vooral vier typen NFSv4-operaties vaker voor te komen:
- OPEN_NOATTR: de aanduiding die Linux gebruikt voor een samengestelde RPC met onder andere SEQUENCE, PUTFH en OPEN.
- CLOSE: sluit een eerder geopend bestand en ruimt de bijbehorende open-state op.
- DELEGRETURN: geeft een delegation terug aan de NFS-server.
- TEST_STATEID: controleert of een NFSv4-state-ID nog geldig is.
Tegelijkertijd nam het aantal STATFS-operaties met ongeveer een factor 8,75 af. GETATTR daalde met een factor 1,3. De stijging zat dus vooral in operaties rond NFSv4-state.
Was de nieuwe Linux-kernel verantwoordelijk?
Bij de dist-upgrade was ook de kernel bijgewerkt, van 6.12.22-1~bpo12+1 naar 6.18.9-1~bpo13+1. Een kernel-regression leek een logische verklaring.
We startten de bijgewerkte machines opnieuw op met de oude Bookworm-kernel, maar het aantal RPC's bleef veel hoger. Vervolgens testten we ook de reguliere Debian 13-kernel 6.12.73+deb13-amd64, in plaats van de backports-kernel. Ook dat maakte geen verschil.
Clients die nog op Bookworm draaiden en dezelfde NFS-server gebruikten, vertoonden aanvankelijk geen stijging. Op beduidend minder drukke clients die al op Trixie draaiden, zagen we het probleem evenmin.
De dist-upgrade bleef daarmee verdacht, maar de kernel zelf kon de oorzaak eigenlijk niet zijn.
Misschien een daemon die zich anders gedroeg?
Bij een dist-upgrade veranderen ook userspace-componenten: daemons, libraries en andere achtergrondprocessen krijgen nieuwe versies.
We vroegen ons daarom af of een meegeüpgradede daemon ineens veel meer files opende en sloot. Dat zou de toename van OPEN-, CLOSE- en DELEGRETURN-operaties verklaren.
We hebben bijvoorbeeld verschillende daemons die veel stat()-calls uitvoeren. Eén daarvan controleert voortdurend of de document-root-symlink van een virtual-host verandert, zodat PHP bij een wijziging herstart wordt. Ook deze daemons waren geüpgraded.
We probeerden de extra RPC's aan een specifiek proces of een bepaalde service te koppelen, maar vonden geen duidelijke veroorzaker.
Ook memory-pressure was geen verklaring. Minder beschikbare RAM voor caching kan tot meer RPC's leiden, maar de hoeveelheid beschikbaar geheugen was ongeveer gelijk gebleven.
Uiteindelijk bleek de upgrade een dwaalspoor
Later werd het beeld ingewikkelder. Op een andere, praktisch identieke filer zagen we het tegenovergestelde patroon: drie Trixie-machines vertoonden geen stijging in RPC-verkeer, terwijl een Bookworm-machine die juist wél had.
Bovendien verdween de extra RPC-belasting op de oorspronkelijke machines eind juni vanzelf, zonder dat we daarvoor een wijziging hadden doorgevoerd. De machines draaiden nog dezelfde kernel.
Ook de D-state-problemen bleken op machines met beide Debian-versies voor te komen. Daarmee hadden we onvoldoende aanwijzingen voor een kernel-regression. De tijdelijke toename van RPC-verkeer konden we uiteindelijk niet verklaren.
Wel vestigde dit onderzoek onze aandacht op de operaties OPEN, CLOSE en DELEGRETURN.
ZFS ARC en nfsd-threads als mogelijke bottleneck
Vervolgens onderzochten we de filers zelf. Onze NFS-servers gebruiken ZFS, waarvan de Adaptive Replacement Cache (ARC) een deel van het RAM gebruikt om veelgebruikte data en metadata te cachen.
We zagen dat de ARC soms onder de ingestelde minimumwaarde zakte. Die minimumwaarde is bedoeld als ondergrens voor hoeveel geheugen ZFS voor de ARC probeert te behouden, al kan de kernel onder bepaalde omstandigheden alsnog geheugen terugvragen. We pasten de minimum- en maximumwaarden aan. Over het afzonderlijke effect van die wijziging op de D-states hebben we geen betrouwbare conclusie vastgelegd.
Een tweede vondst was concreter. Filer nfs1 verwerkte ongeveer 47.500 RPC's per seconde, ongeveer drie keer zoveel als nfs0. Toch draaide nfs1 nog met de Debian-default van acht nfsd-threads. nfs0 gebruikte er al 96.
Die threads verwerken inkomende NFS-verzoeken. Je kunt ze vergelijken met PHP-FPM-workers: wanneer alle threads bezet zijn, moeten nieuwe requests wachten. Over het ideale aantal nfsd-threads bestaan uiteenlopende adviezen, van één per CPU-core tot een vaste waarde van 128, tot "het kan tegenwoordig eigenlijk niet hoog genoeg".
We verhoogden het aantal op nfs1 naar 96. Daarmee verbeterde de tail latency van LOOKUP-operaties direct. De langzaamste requests werden sneller verwerkt, maar de D-states bleven voorkomen.
We onderzochten ook nconnect, waarmee een NFS-client meerdere TCP-verbindingen naar dezelfde server gebruikt. We voegden nconnect=8 toe aan /etc/fstab, maar zagen geen effect.
De verklaring bleek in eerste instantie in het mountgedrag van Linux te zitten: bij mounts naar dezelfde NFS-server geldt de nconnect-instelling van de eerste mount. Latere mounts nemen die instelling over. Om alle bestaande verbindingen en mounts op onze clients opnieuw op te bouwen, was een reboot nodig. Ook daarna, met de juiste nconnect-instelling, was er geen verschil.
Dan maar naar de kernel: stacks wezen naar NFSv4 OPEN en CLOSE
Tot nu toe onderzochten we vooral de omgeving rond de vastlopende processen. Vervolgens wilden we weten waar die PHP-FPM-processen precies op wachtten.
Daarvoor bekeken we hun kernelstacks terwijl ze in D-state stonden. Steeds kwamen we terecht in de NFSv4-client, bijvoorbeeld bij een openat():
rpc_wait_bit_killable
  -> nfs4_run_open_task
  -> nfs4_do_open
  -> nfs4_atomic_open
  -> openat
Of bij een close():
rpc_wait_bit_killable
  -> nfs4_do_close
  -> nfs_file_release
  -> close
Soms zagen we hetzelfde bij nfs4_proc_lookup, aangeroepen vanuit newfstatat().
De processen wachtten dus tijdens gewone OPEN-, CLOSE- en LOOKUP-operaties. We zagen geen patroon waarbij PHP-processen vastliepen tijdens grote reads of writes. De stalls traden juist op tijdens het openen, sluiten en opzoeken van files.
Vier hypotheses die de oorzaak niet verklaarden
NFSv4-delegations waren inmiddels een belangrijke verdachte. Een delegation geeft een client tijdelijk toestemming om bepaalde fileoperations lokaal af te handelen, zodat niet voor iedere operatie een RPC nodig is. Wanneer de client die delegation snel teruggeeft, kan het beheren ervan juist extra RPC's en state-transities opleveren.
We onderzochten mogelijke verklaringen voor de vele delegation-returns en de vertragingen.
1. Delegations werden tussen clients heen en weer gestuurd
Wanneer meerdere clients hetzelfde bestand gebruiken, kan de server een delegation moeten recallen om een conflicterende operatie van een andere client mogelijk te maken. Dat zou extra callbacks en DELEGRETURN-operaties veroorzaken.
We onderzochten /proc/fs/nfsd/clients/*/states gedurende 90 seconden. De betreffende files hadden alleen op de opvallende node delegations, telkens korter dan een seconde. We zagen dus geen aanwijzingen voor voortdurende delegation recalls tussen verschillende clients.
2. Een lokaal proces wijzigde voortdurend dezelfde bestanden
Een writer kan ervoor zorgen dat een bestaande delegation wordt gerecalled. Maar de mtime van het onderzochte bestand lag een week in het verleden.
Inotify registreert geen events voor wijzigingen die andere NFS-clients op de server uitvoeren. Inotify werkt namelijk via de lokale Linux-kernel, dus events op externe filesystems blijven buiten schot. Daardoor konden we deze hypothese niet volledig uitsluiten.
3. De NFS-server deed te lang over OPEN
Met bpftrace maten we de uitvoering van nfsd4_open op nfs1. Meer dan 95% van die operaties was binnen 2 tot 16 microseconden klaar. De uitvoering van nfsd4_open zelf verklaarde daarmee de veel langere wachttijden op de client niet.
4. De inodecache verwijderde voortdurend delegations
Als inodes uit de cache verdwijnen, kunnen bijbehorende delegations eveneens verdwijnen.
Maar de nfs_inode_cache was voor 99% gevuld, met 431.268 inodes in gebruik en 2.378 vrij. We zagen geen aanwijzingen voor shrinker-druk die voortdurende eviction kon verklaren.
We wisten inmiddels dat delegations heel kort leefden. Maar waarom werden ze zo snel teruggegeven?
De doorbraak: vrijwel iedere DELEGRETURN kwam uit close()
We richtten onze metingen vervolgens op nfs_do_return_delegation aan de clientzijde. Met bpftrace onderzochten we vanuit welke codepaden de Linux NFS-client delegations teruggaf.
De resultaten waren opvallend:
| Aanroeppad | Aantal |
|---|---|
nfs4_do_close | 341.834 |
__nfs4_close | 81.875 |
| Nieuwe OPEN met conflicterende delegation | 4 |
Vrijwel alle gemeten delegation-returns kwamen uit het close-pad.
Waarom PHP zoveel opens en closes veroorzaakt
Een PHP-applicatie bestaat doorgaans uit veel afzonderlijke bestanden. Bij een request laadt PHP de benodigde code met bijvoorbeeld require, include of een Composer-autoloader.
OPcache voorkomt dat PHP de code bij iedere request opnieuw moet compileren. De gecompileerde bytecode blijft in het geheugen beschikbaar. Afhankelijk van de configuratie en cachestatus voert PHP nog steeds fileoperations uit om bestanden te vinden of hun geldigheid te controleren. Bij een OPcache-miss moet PHP de code bovendien opnieuw lezen en compileren.
Het accesspattern is hierbij belangrijk: bestanden worden geopend, eventueel gelezen en kort daarna weer gesloten. Bij de onderzochte PHP-FPM-processen leefden open filehandles doorgaans slechts milliseconden.
Dat heeft te maken met het executiemodel van PHP. Bij een traditionele PHP-FPM-applicatie begint iedere HTTP-request opnieuw aan de uitvoering van de applicatie. Hoewel PHP-FPM-workers zelf blijven draaien en OPcache gecompileerde code bewaart, zijn filehandles dus kortlevend.
Dat verschilt bijvoorbeeld van een langlopend Python-proces dat modules tijdens het opstarten importeert en vervolgens in het geheugen houdt.
Wat NFSv4 toevoegt aan NFSv3
NFSv3 stamt uit 1995 en is grotendeels stateless. Voor een gewone fileopen hoeft de server geen administratie bij te houden van welke client het bestand heeft geopend. De client gebruikt bijvoorbeeld LOOKUP om een bestand te vinden en READ om data op te halen.
Filelocking verloopt via aanvullende RPC-protocollen, zoals Network Lock Manager (NLM). Die zijn afzonderlijk van het oorspronkelijke NFS-protocol ontwikkeld: zogenaamde sidecars.
NFSv4 werkt anders. Het protocol houdt state bij voor geopende bestanden en integreert locking in het protocol zelf. Wanneer een client een bestand opent, verwerkt de server een OPEN-operatie en registreert de bijbehorende state. Bij het sluiten volgt een CLOSE, waarmee die state wordt opgeruimd.
Daarnaast ondersteunt NFSv4 delegations. Daarmee draagt de NFS-server een deel van de controle over een bestand tijdelijk over aan een client.
Wanneer een client een bestand opent en daarvoor een delegation krijgt, geeft de server daarmee aan dat de client bepaalde operaties zelfstandig mag uitvoeren. De client hoeft dan bij een volgende compatibele open niet opnieuw aan de server te vragen: mag ik dit bestand openen?
Zolang de delegation geldig is, weet de client dat hij die operaties lokaal mag afhandelen. Wil een andere client iets doen dat daarmee conflicteert, dan stuurt de server een callback met het verzoek om de delegation terug te geven. Dat heet een delegation recall. De client geeft zijn delegation terug voordat de conflicterende operatie kan doorgaan.
Delegations besparen dus RPC's wanneer een client een bestand langdurig openhoudt of herhaaldelijk opent. Het toekennen, beheren en teruggeven van die delegations zelf kost ook RPC's en state-administratie.
We hadden oorspronkelijk voor NFSv4 gekozen vanwege de modernere protocolarchitectuur, het geïntegreerde lockingmodel en de verwachte performancevoordelen. Nu begrepen we waarom die voordelen voor deze PHP-workload niet uit de verf kwamen.
De verklaring zat in de manier waarop de Linux NFSv4-client open references bijhoudt. Een delegation is gekoppeld aan de state van een geopend bestand, de nfs4_state. Zodra de laatste open reference op die state wegvalt, geeft de client de delegation terug.
Daarmee vielen de metingen op hun plek: bij de onderzochte PHP-FPM-processen bleven filehandles doorgaans maar milliseconden open. Bij de laatste close verdween ook de open reference en werd de delegation teruggegeven. Een volgende request kon dus nauwelijks van de delegation profiteren.
De client ontvangt dus bij OPEN een optimalisatie die hij bij CLOSE alweer opruimt. Zowel het toekennen als het teruggeven veroorzaakt overhead, terwijl de delegation geen gelegenheid krijgt om RPC's te besparen.
nfsstat -c bevestigde de omvang van dit gedrag. Sinds het starten van de client waren de volgende operaties uitgevoerd:
| NFSv4-operatie | Aantal | Aandeel |
|---|---|---|
| OPEN_NOATTR | 24.325.345 | 32% |
| CLOSE | 24.282.009 | 32% |
| DELEGRETURN | 23.849.868 | 31% |
Bijna een derde van de getelde NFSv4-operaties bestond uit DELEGRETURN.
Dat betekent extra RPC's, maar ook extra state-transities. In de betrokken codepaden gebruikt Linux verschillende locks om die state veilig te beheren. Aan clientzijde onder andere so_delegreturn_mutex en state_lock, en aan serverzijde fi_lock en st_mutex.
Je kunt die locks vergelijken met een mutex in applicatiecode. Zolang één thread een bepaalde state aanpast, moeten andere threads die dezelfde lock nodig hebben wachten. Bij veel gelijktijdige OPEN- en CLOSE-operaties ontstaat zo een wachtrij.
De gemeten latency van nfs4_do_open aan clientzijde paste bij het vermoeden dat hier vertraging ontstond. De mediaan lag tussen 256 microseconden en 1 milliseconde, met uitschieters tot tientallen milliseconden.
We bespraken de bevindingen ook met conculega's. Het leek aannemelijk dat delegations bij PHP-webhosting weinig waarde toevoegden, omdat filehandles doorgaans maar kort bestaan.
Een delegation hoort RPC's te besparen. In onze metingen veroorzaakte het toekennen en teruggeven ervan juist een enorme hoeveelheid extra verkeer, veroorzaakt door het typische accesspattern van PHP.
Het uitschakelen van delegations was daarmee een logische volgende stap.
Delegations uitschakelen: 24 miljoen RPC's minder, dezelfde D-states
We schakelden vervolgens delegations op nfs1 uit. Daarvoor gebruikten we:
fs.leases-enable=0Delegations zijn een performanceoptimalisatie. Het uitschakelen ervan verwijdert geen fundamenteel consistentiemechanisme uit NFS. Close-to-open consistency, attribuutcaching, filelocking via flock en fcntl, writes en SETATTR blijven beschikbaar.
Het resultaat was technisch precies wat we verwachtten. Door delegations uit te schakelen verdwenen ongeveer 24 miljoen RPC's per dag. Daarmee verwijderden we aantoonbaar een grote hoeveelheid protocoloverhead.
De D-states bleven bestaan. We hadden met bpftrace vastgesteld waar de delegation-returns vandaan kwamen en met nfsstat gemeten hoeveel verkeer ze veroorzaakten. De ingreep verwijderde die overhead, maar leverde geen meetbare verbetering op voor het oorspronkelijke probleem.
Dat valt achteraf te verklaren: OPEN en CLOSE moesten nog steeds state aanmaken en opruimen. Juist die operaties zagen we voortdurend terug in de kernelstacks van de vastlopende PHP-processen. Delegations uitschakelen verwijderde DELEGRETURN, maar liet het overige statebeheer intact.
Terug naar NFSv3: OPEN- en CLOSE-state volledig verwijderen
Daarom besloten we eerst één van de getroffen hostingomgevingen over te schakelen naar NFSv3.
NFSv3 kent voor gewone fileopens geen server-side OPEN- en CLOSE-state.
Ons vermoeden was dat juist dat gunstig zou zijn voor het PHP-accesspattern: veel opens en closes, met filehandles die doorgaans maar milliseconden open blijven.
Wanneer een client een file opent, haalt hij met bijvoorbeeld LOOKUP en READ de benodigde informatie en data op. Er hoeft geen open-state op de server te worden aangemaakt die later met CLOSE weer wordt opgeruimd. Daarmee verdwijnt het deel van de NFSv4-protocoladministratie waarin we de PHP-FPM-processen zagen wachten.
We gebruiken de volgende mount-opties:
vers=3,rsize=65536,wsize=65536,hard,nconnect=16,
timeo=600,retrans=2,local_lock=none,noatime,
nodiratime,_netdev
De D-states verdwenen: NFSv3 ook op onze andere NFS-omgevingen
Na de overstap naar NFSv3 verdwenen de eerder waargenomen D-state-problemen als sneeuw voor de zon.
We hielden de eerste omgeving vervolgens zes weken op NFSv3 om te controleren of de verbetering aanhield. Omdat de problemen wegbleven, schakelden we ook een tweede NFS-hostingomgeving over, die gebruikmaakte van filer nfs0.
Daarna pasten we ook nfs2 aan. Op deze filer waren op dat moment nog geen NFSv3-clients aangesloten, maar we wilden de configuratie van onze filers consistent houden. De migratie betrof onze NFS-omgevingen voor geclusterde hosting, niet het volledige Cyberfusion-platform.
Waarom NFSv3 voor PHP-webhosting beter werkt
De uitkomst is te verklaren vanuit het typische accesspattern van PHP.
Een PHP-request veroorzaakt veel kortlevende filehandles. Een file wordt geopend, eventueel gelezen en daarna direct gesloten. NFSv4 houdt voor zulke opens state bij op de server. De client en server moeten die state aanmaken, synchroniseren en weer opruimen.
Delegations voegen daar een optimalisatie aan toe. Die is waardevol wanneer een client langdurig toegang houdt tot een file en daardoor meerdere operaties lokaal afhandelt.
Maar bij PHP-workloads worden delegations vaak alweer bij de eerstvolgende close teruggegeven. Daardoor veroorzaken ze vooral extra RPC's, terwijl er nauwelijks gelegenheid is om van de optimalisatie te profiteren.
Ons onderzoek liet drie situaties zien:
- NFSv4.2 met delegations: OPEN, CLOSE en DELEGRETURN zorgden voor veel RPC-verkeer en state-administratie.
- NFSv4.2 zonder delegations: DELEGRETURN verdween vrijwel volledig, maar OPEN en CLOSE bleven. De D-states veranderden niet.
- NFSv3: de server-side OPEN- en CLOSE-state verdween uit het protocolpad. Daarna verdwenen ook de onderzochte D-state-problemen.
We hebben geen specifieke kernel-lock aangewezen als de exclusieve oorzaak van iedere stall. De combinatie van kernelstacks, RPC-statistieken, bpftrace-metingen en de resultaten van beide wijzigingen wijst wel overtuigend naar de NFSv4-stateverwerking.