Weet je waar je servercapaciteit naartoe gaat?
Voor webbureaus, SaaS-bedrijven en grotere platforms is het heel gebruikelijk om meerdere websites of applicaties op dezelfde server te draaien.
Dat werkt prima, totdat een van die projecten plotseling veel meer resources gaat gebruiken.
Misschien is een WordPress-plugin na een update meer geheugen gaan verbruiken. Of draait een cronjob veel langer dan gebruikelijk. Bij een SaaS-applicatie kan één klant verantwoordelijk zijn voor een groot deel van de databasebelasting.
Je merkt dat de server drukker wordt, maar welke applicatie is daarvoor verantwoordelijk?
Bij Cyberfusion monitoren we de onderliggende infrastructuur 24/7. We houden onder andere de beschikbaarheid, belasting en gezondheid van servers in de gaten en grijpen in wanneer dat nodig is.
Maar niet ieder performanceprobleem laat zich herkennen aan de totale serverbelasting. Een server kan prima functioneren, terwijl één applicatie structureel meer geheugen verbruikt dan nodig of na een deployment minder efficiënt is geworden.
Daarom hebben we de metrics in Cyberfusion Core uitgebreid.
Je kunt nu rechtstreeks in Core zien hoeveel resources afzonderlijke projecten en processen verbruiken, en hoe dat verbruik zich over de tijd ontwikkelt.
Zo combineren we de monitoring en het proactieve beheer van Cyberfusion met het inzicht dat developers nodig hebben om hun eigen applicaties te optimaliseren.
CPU- en RAM-gebruik per project in één overzicht
De nieuwe metrics geven inzicht in het resourceverbruik van verschillende onderdelen van je applicaties.
Core verzamelt metrics voor onder andere:
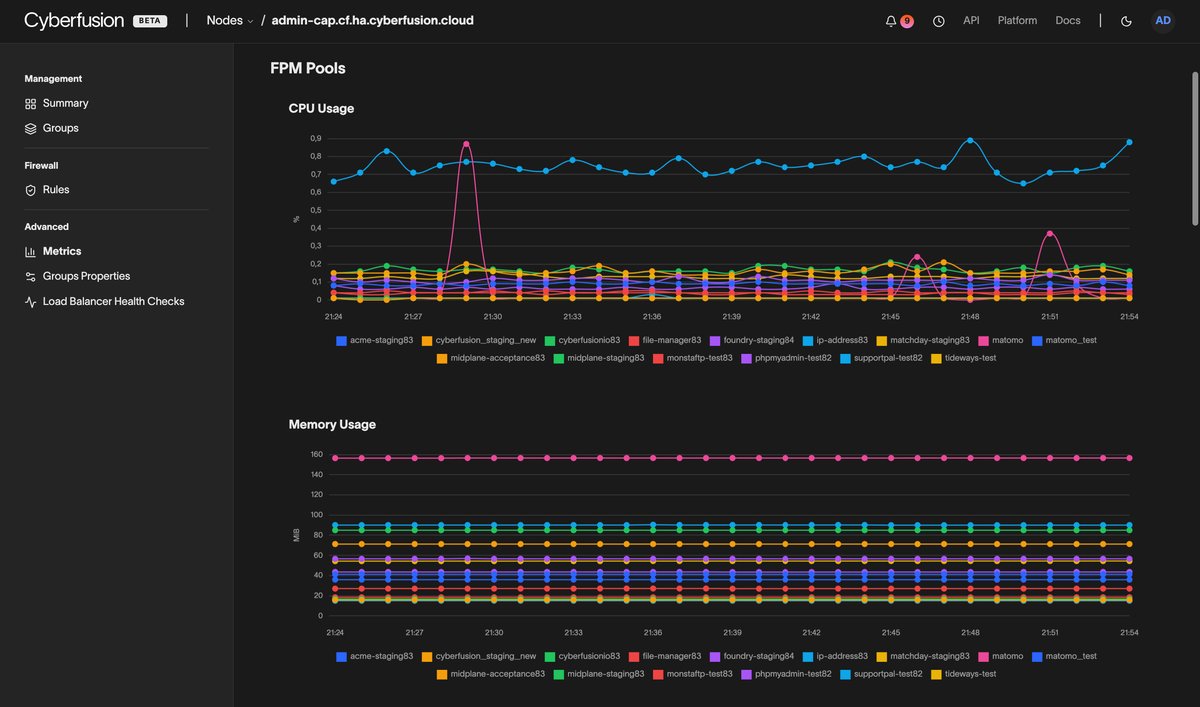
- PHP-FPM-pools: CPU- en geheugengebruik van de PHP-processen die je website of applicatie uitvoeren.
- Daemons: CPU- en geheugengebruik van langdurig draaiende achtergrondprocessen, zoals queue workers.
- Cronjobs: CPU- en geheugengebruik van periodiek uitgevoerde taken.
- Databasegebruikers: CPU-gebruik en het aantal databaseverbindingen per databasegebruiker.
Ook voor Passenger-applicaties, bijvoorbeeld in Node.js, zijn CPU- en geheugenmetrics beschikbaar.
Je kunt deze gegevens op twee manieren bekijken: voor een afzonderlijk project of voor alle processen op een node.
Dat onderscheid is belangrijk. Soms wil je weten waarom één specifieke website traag is. Op andere momenten wil je begrijpen waarom een hele server zwaar wordt belast.
Met Core kun je beide onderzoeken.
Alle processen op een node: waar gaat de capaciteit naartoe?
Stel dat je een node beheert waarop vijftig websites draaien.
De CPU-belasting loopt regelmatig op en sommige websites reageren trager. Je vermoedt dat een van de projecten de oorzaak is, maar weet nog niet welke.
In Core kun je de metrics van de volledige node bekijken.
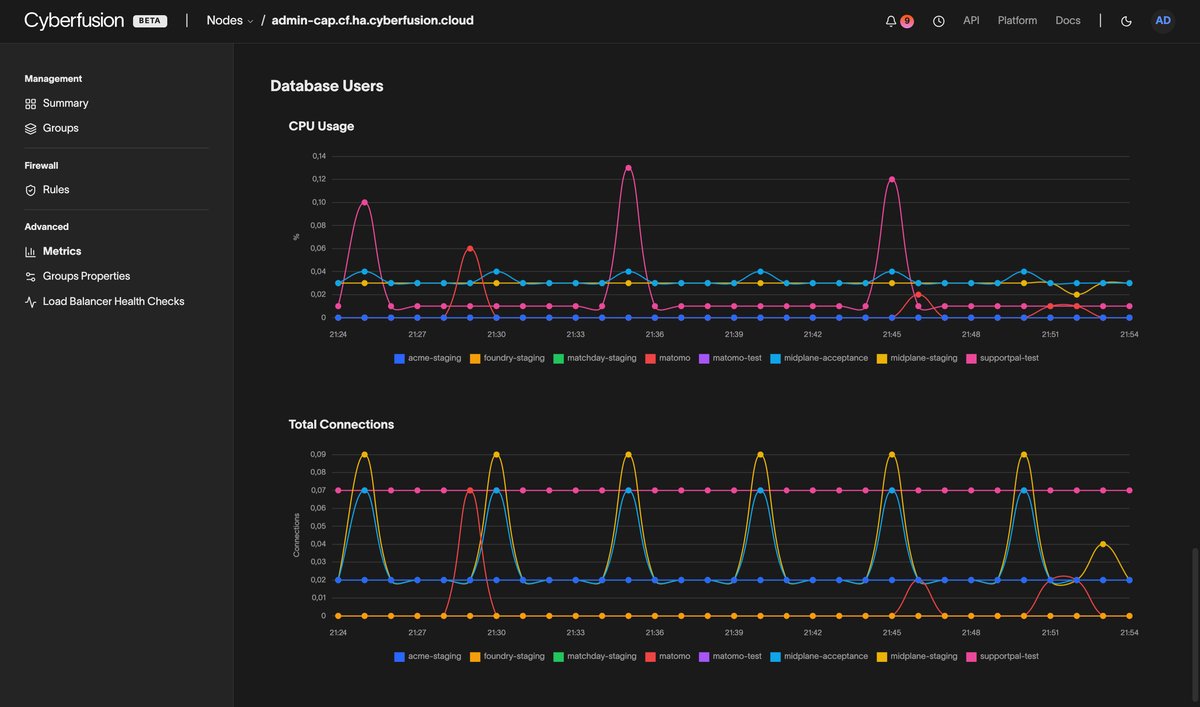
Je ziet dan het verbruik van alle PHP-FPM-pools, daemons, cronjobs en databasegebruikers op die node.
Daarmee kun je bijvoorbeeld ontdekken dat:
- Eén WordPress-website structureel veel meer CPU gebruikt dan de overige websites.
- Een daemon steeds meer geheugen verbruikt.
- Een periodieke cronjob verantwoordelijk is voor terugkerende CPU-pieken.
- Een specifieke databasegebruiker opvallend veel CPU-capaciteit vraagt of databaseverbindingen opent.
In plaats van direct de servercapaciteit te verhogen, kun je eerst onderzoeken welk project de belasting veroorzaakt.
Misschien blijkt een cronjob onnodig vaak te draaien. Of is een applicatie na een update minder efficiënt geworden.
Door het probleem bij de bron aan te pakken, kun je voorkomen dat alle projecten op de node last krijgen van één afwijkende applicatie.
En wanneer de totale capaciteit van de node daadwerkelijk tekortschiet, kunnen we dat eveneens onderbouwen met metingen. Onze engineers kunnen dan adviseren over bijvoorbeeld het aanpassen van de configuratie, het verdelen van workloads of het uitbreiden van de beschikbare resources.
Metrics per project: zie wat je applicatie daadwerkelijk verbruikt
Je kunt ook inzoomen op een afzonderlijk project.
Dat is handig voor developers die willen weten wat hun applicatie onder normale omstandigheden verbruikt, hoeveel capaciteit een nieuwe functionaliteit vraagt of waarom een probleem op een bepaald moment ontstond.
Core laat het resourceverbruik over verschillende perioden zien: een halfuur, een dag of een maand.
Daarmee kun je niet alleen zien wat er op dit moment gebeurt, maar ook hoe het verbruik zich ontwikkelt.
Wat gebeurt er na een deployment?
Stel dat je een nieuwe versie van je applicatie uitrolt.
De nieuwe functionaliteit werkt zoals verwacht, maar je wilt weten of de wijziging invloed heeft gehad op het resourceverbruik.
Met de historische metrics kun je de CPU- en geheugenbelasting van vóór en na de deployment vergelijken.
Zie je dat het geheugengebruik van de PHP-FPM-pool sindsdien structureel hoger ligt? Dan heb je een concreet aanknopingspunt om verder te onderzoeken.
Misschien worden er meer gegevens in het geheugen geladen. Of duurt de verwerking van bepaalde verzoeken langer, waardoor meer PHP-processen tegelijk actief zijn.
Waarom wordt mijn applicatie iedere nacht trager?
Een ander voorbeeld: een applicatie wordt iedere nacht rond hetzelfde tijdstip traag.
Door de metrics over een langere periode te bekijken, ontdek je mogelijk dat een cronjob precies op dat moment veel CPU gebruikt.
Dat kan bijvoorbeeld een import, synchronisatie of periodieke rapportage zijn.
Je kunt vervolgens onderzoeken of de taak efficiënter kan worden uitgevoerd, minder vaak hoeft te draaien of beter op een ander moment kan worden ingepland.
Zo ondersteunen de metrics niet alleen het oplossen van storingen, maar ook het structureel verbeteren van applicaties.
Een afwijkend patroon ontdekt? Onze engineers kijken mee
Metrics maken zichtbaar wat er gebeurt, maar verklaren niet waarom.
Stel dat je ziet dat het geheugengebruik van een PHP-FPM-pool al weken geleidelijk toeneemt. Of dat de databasebelasting iedere avond sterk oploopt, terwijl het bezoekersverkeer nauwelijks verandert.
Je kunt dan zelf onderzoeken of er recent iets aan de applicatie is gewijzigd. Maar soms is de oorzaak minder eenvoudig vast te stellen.
Daar komt het managed-hostingaspect van Cyberfusion om de hoek kijken.
Onze engineers kennen de infrastructuur waarop je applicaties draaien en kunnen helpen bij het interpreteren van de metrics. We kunnen bijvoorbeeld meedenken over of:
- Een PHP-FPM-pool te veel gelijktijdige processen start of onnodig veel geheugen vasthoudt.
- Een database onvoldoende gebruikmaakt van de beschikbare geheugenbuffers.
- Een cronjob of daemon onnodig veel CPU-capaciteit verbruikt.
- De ingestelde resource-limits onvoldoende aansluiten op het werkelijke verbruik.
- Een applicatie tegen de grenzen van de beschikbare servercapaciteit aanloopt.
We kunnen daarbij verder kijken dan alleen de grafieken. Afhankelijk van het probleem kunnen we ook PHP-FPM-instellingen, databaseconfiguraties, slow-requestlogs en andere technische gegevens onderzoeken.
Dat maakt het eenvoudiger om onderscheid te maken tussen een probleem in de applicatie en een probleem dat met de serverconfiguratie of beschikbare capaciteit samenhangt.
Resource-limits instellen op basis van daadwerkelijke metingen
In Cyberfusion Core kun je per PHP-FPM-pool, daemon of cronjob limieten instellen voor het gebruik van CPU en geheugen.
Stel dat een WordPress-website door een fout in een plugin plotseling vrijwel alle beschikbare CPU-capaciteit opeist. Zonder begrenzing kan dat ook de prestaties van andere websites op dezelfde node beïnvloeden.
Met een CPU-limiet kun je voorkomen dat één procesgroep alle beschikbare CPU-capaciteit gebruikt.
Maar welke limiet stel je dan in?
Zonder metingen wordt dat al snel giswerk. Een limiet die te laag is, kan de prestaties van een applicatie onnodig beperken. Een limiet die te hoog is, biedt mogelijk onvoldoende bescherming wanneer een proces uit de hand loopt.
De nieuwe metrics helpen je om die keuze te baseren op daadwerkelijk verbruik.
Je kunt bijvoorbeeld:
- Het normale CPU- en geheugengebruik van een project gedurende een maand bekijken.
- Onderzoeken hoeveel capaciteit het project tijdens gebruikelijke pieken nodig heeft.
- Op basis daarvan een passende CPU- of geheugenlimiet instellen.
- De metrics blijven volgen om te controleren of de limiet aansluit op de werkelijke belasting.
Dat maakt het mogelijk om beschikbare capaciteit beter over projecten te verdelen en te voorkomen dat een enkel project de rest van de server beïnvloedt.
Kom je er niet uit welke limieten passend zijn? Dan kunnen onze engineers op basis van de metrics en de beschikbare nodecapaciteit met je meekijken.
Inzicht per klant voor webbureaus en SaaS-bedrijven
Voor organisaties die meerdere klantomgevingen beheren, zijn metrics per project extra interessant.
Een webbureau kan bijvoorbeeld tientallen WordPress-websites op dezelfde node hosten. Sommige websites krijgen veel verkeer, terwijl andere slechts een paar keer per dag worden bezocht.
Met de metrics kun je zien welke projecten daadwerkelijk capaciteit gebruiken.
Dat helpt bij het optimaliseren van websites, het verdelen van resources en het bepalen wanneer extra servercapaciteit nodig is.
Voor SaaS-bedrijven geldt hetzelfde, zeker wanneer verschillende klanten of tenants hun eigen PHP-FPM-pool en databasegebruiker hebben.
Je kunt dan per klantomgeving onderzoeken:
- Hoeveel CPU en geheugen de applicatie gebruikt.
- Of het verbruik in de loop van de tijd toeneemt.
- Welke klanten of processen opvallend veel resources nodig hebben.
- Of de ingestelde resource-limits nog passend zijn.
Zo kun je per klant zien hoeveel resources de applicatie verbruikt en of je moet bijsturen.
Dat is bijvoorbeeld waardevol wanneer je een nieuwe klant onboardt, een applicatie uitbreidt of wilt onderzoeken waarom een specifieke tenant minder goed presteert dan andere.
Waarom inzicht in resourceverbruik juist nu belangrijk is
Er is nog een reden waarom we deze metrics belangrijk vinden: de wereldwijde schaarste aan serverhardware.
In ons eerdere artikel RAMmageddon: waarom hosting overal duurder wordt beschreven we hoe de groei van AI-datacenters de beschikbaarheid en prijzen van onder andere werkgeheugen en SSD's beïnvloedt.
Dat maakt efficiënt gebruik van bestaande hardware steeds belangrijker.
Natuurlijk heeft iedere applicatie voldoende resources nodig om goed te functioneren. Maar wanneer één slecht geconfigureerde applicatie onnodig veel geheugen gebruikt, wil je dat kunnen herkennen voordat je een server moet upgraden.
Een voorbeeld: een node raakt steeds voller en je overweegt extra geheugen toe te voegen. Uit de metrics blijkt echter dat één daemon structureel veel meer geheugen gebruikt dan verwacht.
Na onderzoek ontdek je dat deze daemon onnodig veel gegevens in het geheugen vasthoudt.
Door dat probleem op te lossen, komt er capaciteit vrij voor andere projecten. Mogelijk kun je daarmee een hardware-uitbreiding uitstellen of voorkomen.
Ook vanuit Cyberfusion kijken we voortdurend hoe we de beschikbare servercapaciteit zo efficiënt mogelijk kunnen inzetten. Bijvoorbeeld door PHP-FPM- en databaseconfiguraties te optimaliseren en klanten te adviseren wanneer we opvallende patronen in het resourceverbruik constateren.
De nieuwe metrics helpen daarbij: ze maken het eenvoudiger om samen te onderzoeken waar capaciteit naartoe gaat en welke verbeteringen mogelijk zijn.
Niet iedere capaciteitsuitbreiding is te voorkomen. Maar voordat je extra resources aanschaft, wil je weten waar de bestaande capaciteit aan wordt besteed.
Nu hardware steeds schaarser en duurder wordt, kan dat een aanzienlijk verschil maken.
Zelf inzicht, mét de ondersteuning van échte managed hosting
Bij veel hostingoplossingen krijg je toegang tot servermetrics, waarna je zelf verantwoordelijk bent voor de interpretatie, configuratie en het oplossen van problemen.
Cyberfusion combineert die inzichten met het beheer en de expertise van onze engineers.
- Zelf onderzoeken: je ziet welke projecten en processen veel CPU, geheugen of databasecapaciteit gebruiken.
- Gerichter optimaliseren: je kunt veranderingen over langere tijd vergelijken en resource-limits afstemmen op het daadwerkelijke verbruik.
- Proactief beheer: onze engineers bewaken de onderliggende infrastructuur en grijpen in wanneer de monitoring daar aanleiding toe geeft.
- Samen problemen oplossen: ontdek je een afwijkend patroon of loop je tegen een capaciteitsprobleem aan, dan kunnen onze engineers helpen om de oorzaak te achterhalen en passende maatregelen te bepalen.
Zo heb je de controle en inzichten die je als developer nodig hebt, en kun je onze expertise altijd inzetten voor aanvullend onderzoek en advies.
Bekijk de metrics van je projecten in Cyberfusion Core
Gebruik je Cyberfusion Core? Dan zijn de nieuwe metrics direct beschikbaar.
Je vindt ze op twee plekken:
- Per project: ga naar Projects, selecteer een project en open Insights → Metrics. Hier zie je het resourceverbruik van de processen en databasegebruikers die bij dat project horen.
- Per node: ga naar Servers → Nodes, selecteer een node en open Advanced → Metrics. Hier zie je het verbruik van alle relevante processen en databasegebruikers op die node.
Meer weten over het interpreteren van de metrics en het voorbereiden op piekbelasting? Lees onze documentatie over servercapaciteit en piekverkeer.
Zie je opvallend CPU- of geheugengebruik, of twijfel je of je applicaties voldoende capaciteit hebben? Neem contact met ons op. Onze engineers kijken graag mee.
Nog geen klant? Ontdek Cyberfusion Core, het échte managed-hostingplatform voor webprofessionals.